







187
115
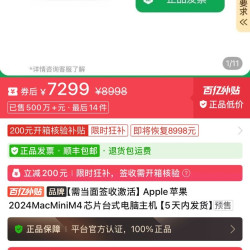
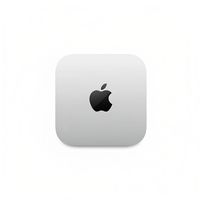
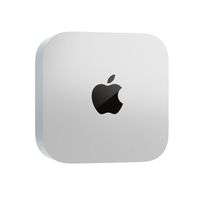
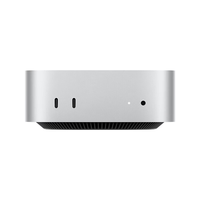
Apple MacMini M4 24G 512G 跑本地大模型,7299 元近期好价
7299元

值得买客户端
扫一扫购买
查看大图

爆料原文:
24GB 内存是跑本地大模型的“甜点级”配置。 它能让你以可接受的速度运行 14B 级别的模型,但需要避开 32B 及以上模型,否则会因内存不足导致系统卡顿。
能跑什么模型(速度实测)
在 M4 基础款 + 24GB 内存下,建议锁定 4-bit 量化模型:
· 7B / 8B(如 Qwen2.5-Coder, Llama 3.1):20~30 tok/s。体验流畅丝滑,非常适合代码补全、翻译、总结等高频任务。
· 14B(如 Qwen2.5-14B, DeepSeek-R1):11~14 tok/s。这是最佳平衡点,速度虽不如小模型,但推理能力明显更强,适合日常对话。
· 22B(如 Mistral Small):7~9 tok/s。速度偏慢,能明显感觉到等待,仅在 14B 不够用时尝试。
· 32B 及以上:不建议。24GB 内存跑 32B 很容易爆内存并调用硬盘当虚拟内存(Swap),导致速度断崖式下跌到个位数,甚至系统卡死。
关键提醒
· 选对工具:Ollama 最简单,LM Studio 有图形界面。若追求极致速度,MLX 框架(苹果原生)通常比 Ollama 快 10%~50%。
· 内存预留:虽然 24GB 看着多,但系统本身要占几个 G。跑 14B 模型时,建议把上下文长度(Context Length) 控制在 4K~8K,给 KV Cache 留空间,否则容易报错。
· 预期管理:它的智力水平大致相当于早期的 GPT-3.5,适合“高频、简单、隐私敏感”的任务(如本地文档总结、代码辅助)。硬核的复杂逻辑推理,还是云端模型更强。
什么值得买是一家中立的消费门户网站,好价信息来自热心值友爆料和商家自荐,经小编人工审核或小值机器人智能判断后发布。促销折扣可能随时变化,请值友们购买前注意核实。
好价信息中“价格标签”及“比价结果”均为系统自动计算生成,详情请查看功能说明。
我要举报:
-
好价失效
请选择举报理由:
-
内容问题
请选择举报理由:
- 商品问题
请选择举报理由:
-
侵权举报
请选择举报理由:
- 其他
相关选购指南

70块给windows加一个人脸识别,再也不用输密码了
前言最近入手了零刻的GTR 5小主机,上面的指纹解锁极大地增加了我的舒适感,指纹识别很灵敏,只要一碰就解锁了,非常方便。可能有人会杠,那你不设置密码不就完了?那确实也是一种方法,不过个人习惯,不接受反
290
1.1k
358

带触控屏的迷你主机:搭载N4000,支持双4K显示器拓展
厂商HIGOLE日前推出了自家新款迷你主机GOLE1 Pro 2022,有意思的是,其配备了5.5英寸IPS触控屏,并支持最多两个4K显示屏拓展,使其能够成为一款三显示器设备。官方未公布关于这个5.5
138
566
173

R9 7900X 整机的游戏体验 + 专业生产力体验,附上三代 R9 同台竞技
稳定又切实的进步▲ 借用一张 AMD 发布会上的路线图,AMD 从 Zen 架构 CPU 诞生以来,不断在 CPU 架构与 生产工艺上优化着 Zen 系列的架构,比如:Zen+ 架构对于 Zen 架构
102
67
84

从小白到装机入门一篇就够了,一步到位挑战高难度装机
本文内容较长,将近9k字,也是我从零到装机成功心路历程的记录,选择的装机方案为了颜值,确实难度挺高。有兴趣的朋友可以耐心观看,前半部分基本知识普及,后半部分实战装机、系统安装以及稳定性测试。欢迎大家给
59
231
45
相关推荐
0评论


当前文章无评论,是时候发表评论了
提示信息
取消
确认
评论举报
本文收录在
最新好价
热门好价
-
 希未 R27工作站20389.01元包邮
-
希未 R27工作站20389.01元包邮
-
 口袋玲珑 星核工作站21879.01元包邮
-
 EVO-X222874.01元包邮
-
 EVO-X321590.51元包邮
-
 EVO-X214914.01元包邮
-
 雷神 水冷超算AI Mini工作站26359.01元包邮
-
 光明 优倍鲜牛奶185ml*12瓶22.48元
-
 京觅 宜昌蜜桔青皮无籽蜜橘 净重8斤单果50mm+19.9元(需用券)
-
 金典 伊利金典纯牛奶250ml*24盒整箱7月产41.04元
-
 评论有奖:夏末到初秋,全品类挖宝局,评论得现金!天天参与!奖励累加!
-
 Anker 60W快充 双Type-C口 尼龙织 数据线11.83元
-
 酷态科 10号MINI迷你充电宝电芯10000毫安移动电源112.97元
-
 京鲜生 钦蜜9号黄金百香果 净重4.5斤19.99元
热门众测
-
 全屋畅行热水洗烘,有宠家庭认证放心之选,石头P30Pro深度评测
-

-
海淘
好价
百科
-
 技嘉 X870 Gaming X WIFI7 主板$169.99
-
-
 微星 PRO B550MP 主板$69.99
-
-
光明 优倍鲜牛奶185ml*12瓶22.48元
-
京觅 宜昌蜜桔青皮无籽蜜橘 净重8斤单果50mm+19.9元(需用券)
-
 铭凡 N5 MAX 锐龙AI Max+395 万兆网口 迷你主机15999元起
-

-
-
-

-
